前文背景就是这篇文章:https://brucewayne2099.github.io/2026/03/19/%E6%9C%AC%E5%9C%B0%E6%90%AD%E5%BB%BA%E4%B8%80%E4%B8%AAollama%E5%A4%A7%E6%A8%A1%E5%9E%8B/
我现在打算加一个功能,就是加入openai-whisper,实现在web端用语音与ai交流的目的。对应的backend.py成了:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
from flask import Flask , render_template, request, jsonify from prometheus_client import start_http_server, Summary import requestsimport whisperimport osimport timeapp = Flask (__name__) LATENCY = Summary ('ai_inference_seconds' , 'Time spent processing LLM prediction' ) STT_LATENCY = Summary ('speech_to_text_seconds' , 'Time spent on Whisper transcription' ) stt_model = whisper.load_model ("base" ) print ("Whisper 加载完成,可以实现语音交流。" )@app .route ('/' )def index (): return render_template ('index.html' ) # 这里多了一个index.html,在页面里有一个喇叭按钮,可以传入语音 @app .route ('/speech_to_text' , methods=['POST' ])def stt (): if 'file' not in request.files: return jsonify ({"error" : "未收到音频文件" }), 400 file = request.files['file' ] file_path = "temp_audio.webm" file.save (file_path) try : with STT_LATENCY.time (): result = stt_model.transcribe (file_path, language="zh" ) text = result.get ("text" , "" ).strip () return jsonify ({"text" : text}) except Exception as e: return jsonify ({"error" : str (e)}), 500 finally : if os.path.exists (file_path): os.remove (file_path) @app .route ('/aigpt_api' )def aigpt_api (): user_prompt = request.args.get ('prompt' , '' ) if not user_prompt: return jsonify ({"response" : "大哥,你还没说话呢" }) ollama_url = "http://ollama-svc:11434/api/generate" try : with LATENCY.time (): r = requests.post ( ollama_url, json={ "model" : "llama3:70b" , # 确保你 pull 的是这个名字 "prompt" : user_prompt, "stream" : False }, timeout=300 ) r.raise_for_status () return jsonify (r.json ()) except requests.exceptions.Timeout : return jsonify ({"response" : "⚠️ 70B 思考太久超时了,建议给 Pod 更多 CPU 资源" }), 504 except Exception as e: return jsonify ({"response" : f"❌ 后端报错: {str(e)}" }), 500 if __name__ == '__main__' : app.run (host='0.0.0.0' , port=5000 )
Dockerfile也改成了这样:
1 2 3 4 5 6 7 8 9 10 11 12 13 FROM docker.m.daocloud.io/library/python:3.9 -slimRUN apt-get update && apt-get install -y ffmpeg RUN pip install flask prometheus_client requests openai-whisper setuptools wheel WORKDIR /app COPY . . CMD ["python" , "backend.py" ]
修改了Dockerfile之后,我们来打包一个镜像ai-backend v8版本:docker build -t ai-backend:v8 . ,然后通过docker images |grep v8里看本地的确有了docker images库里的确有了ai-backend:v8这个镜像。这个镜像挺大的,足足11G。
但是要注意这个镜像还不在k3s里,所以还要执行docker save ai-backend:v8 |sudo k3s ctr images import - , 这样k3s的镜像库才也有了这个ai-backend:v8的镜像,可以用k3s ctr images list|grep ai-backend这个命令来确认。
然后我就执行kubectl rollout restart deployment ai-backend来滚动发布。
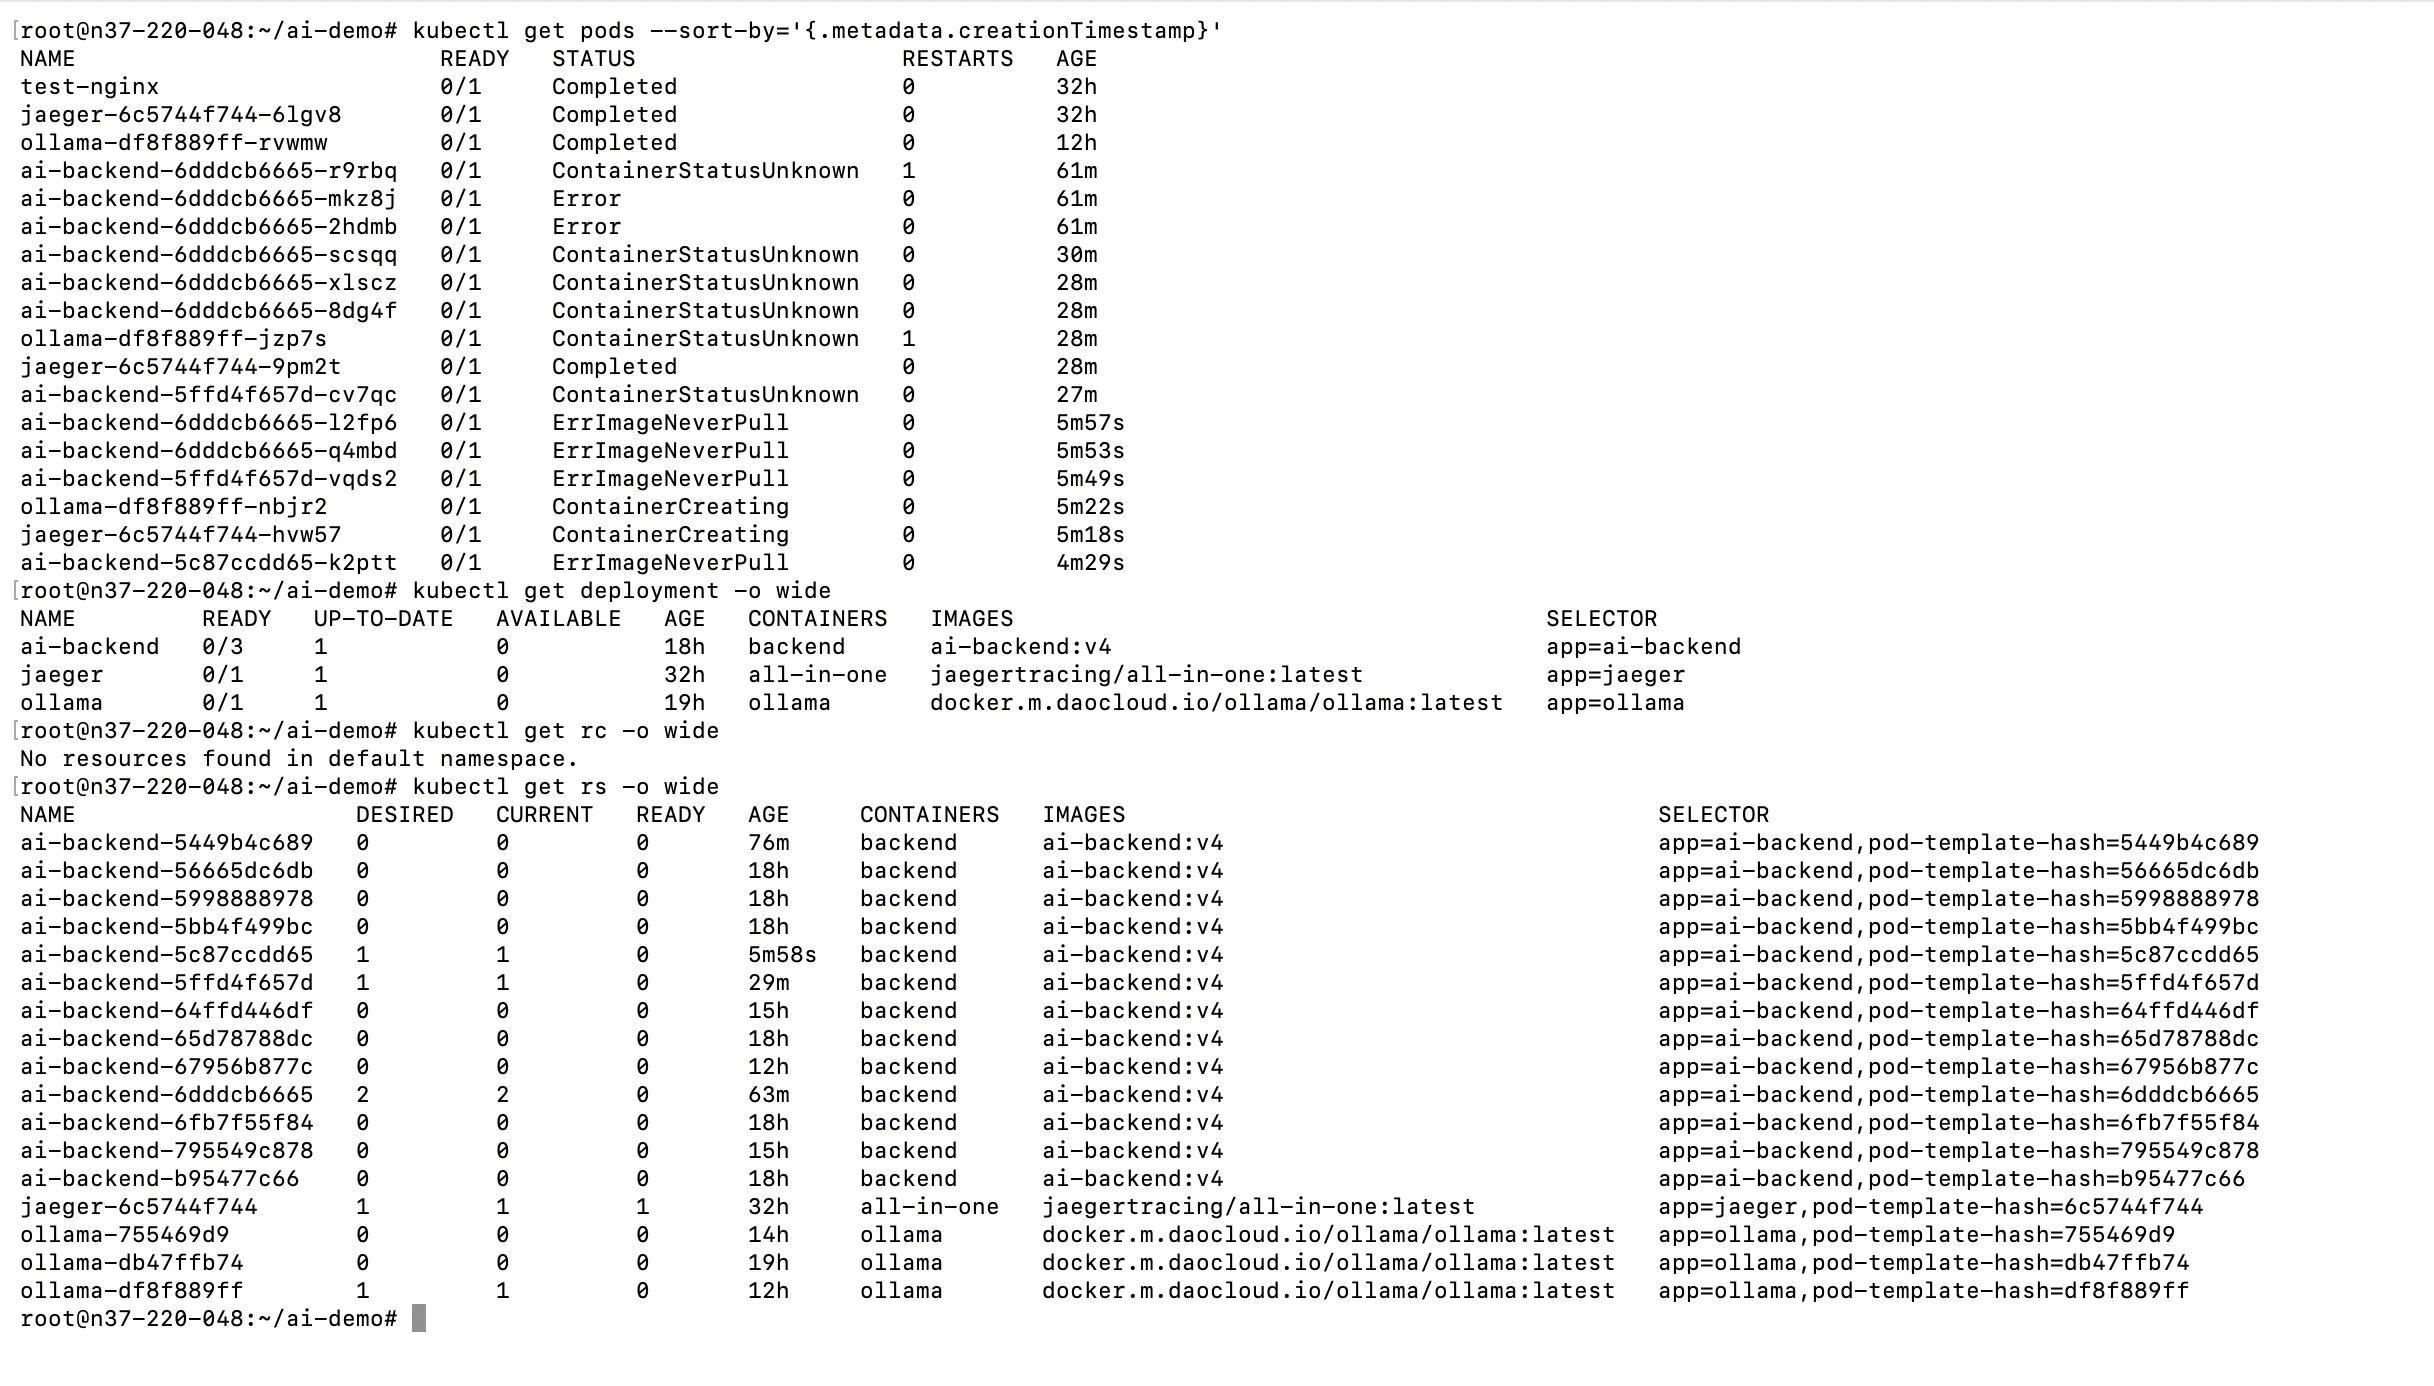
发布完后,测试发现跟上一次发布的内容没变化,我检查了一下原来是deployment.yaml里忘改成v8镜像了,修改了之后,又执行kubectl rollout restart deployment ai-backend,此时发现所有的pod全挂了:
多个Deployment同时存在:有3个不同的ReplicaSet(5c87ccdd65, 5ffd4f657d, 6dddcb6665)
Pod状态异常:Pending、Error、ContainerStatusUnknown、Completed
Deployment未就绪:所有Deployment都是0/1或0/3
然后赶紧kubectl log发现报错kubelet Node n37-220-048 status is now: NodeHasNoDiskPressure,整个node没有磁盘空间了,果然打开一看120G的本地盘已经达到了95%。
于是赶紧kubectl delete deployment ai-backend -i ai-demo来释放空间,然后手动删除掉这些不应该生成的rs,再通过kubectl get rs -n ai-demo来确认。
然后docker image prune -f清理docker镜像,发现k3s ctr里找不到v8镜像了。
先把ollama pod恢复回来,让其他人可以先用exec -it或者curl的形式能访问ai,暂时先对付用。
原因查明 我这个开发机原来是120G的本地盘,里面下载了8B的大模型7G,还有一个70B的大模型 42G,已经占用了50G。
首先,docker build的时候会产生一个11G的镜像,然后执行了docker save ai-backend:v4 |sudo k3s ctr images import - ,其实这一步是一个拷贝工作,所以这里又是22G,然后我dockerfile有一个地方变化了,导致v8又是一个新的镜像,这里面就用了80G左右,
此时磁盘空间不足,又因为我执行了rollout restart,deployment就不断的起新rs,rs去创建新pod,新pod就要去加载这个11G的v8镜像。kubelet此时需要干掉镜像来救磁盘,于是就把我的v8镜像干掉了,导致ErrImageNeverPull的错误,但是deployment看到pod挂了,还是再不断生成rs,于是就莫名其妙多出来很多个rs,每个rs下都有挂掉的pod。
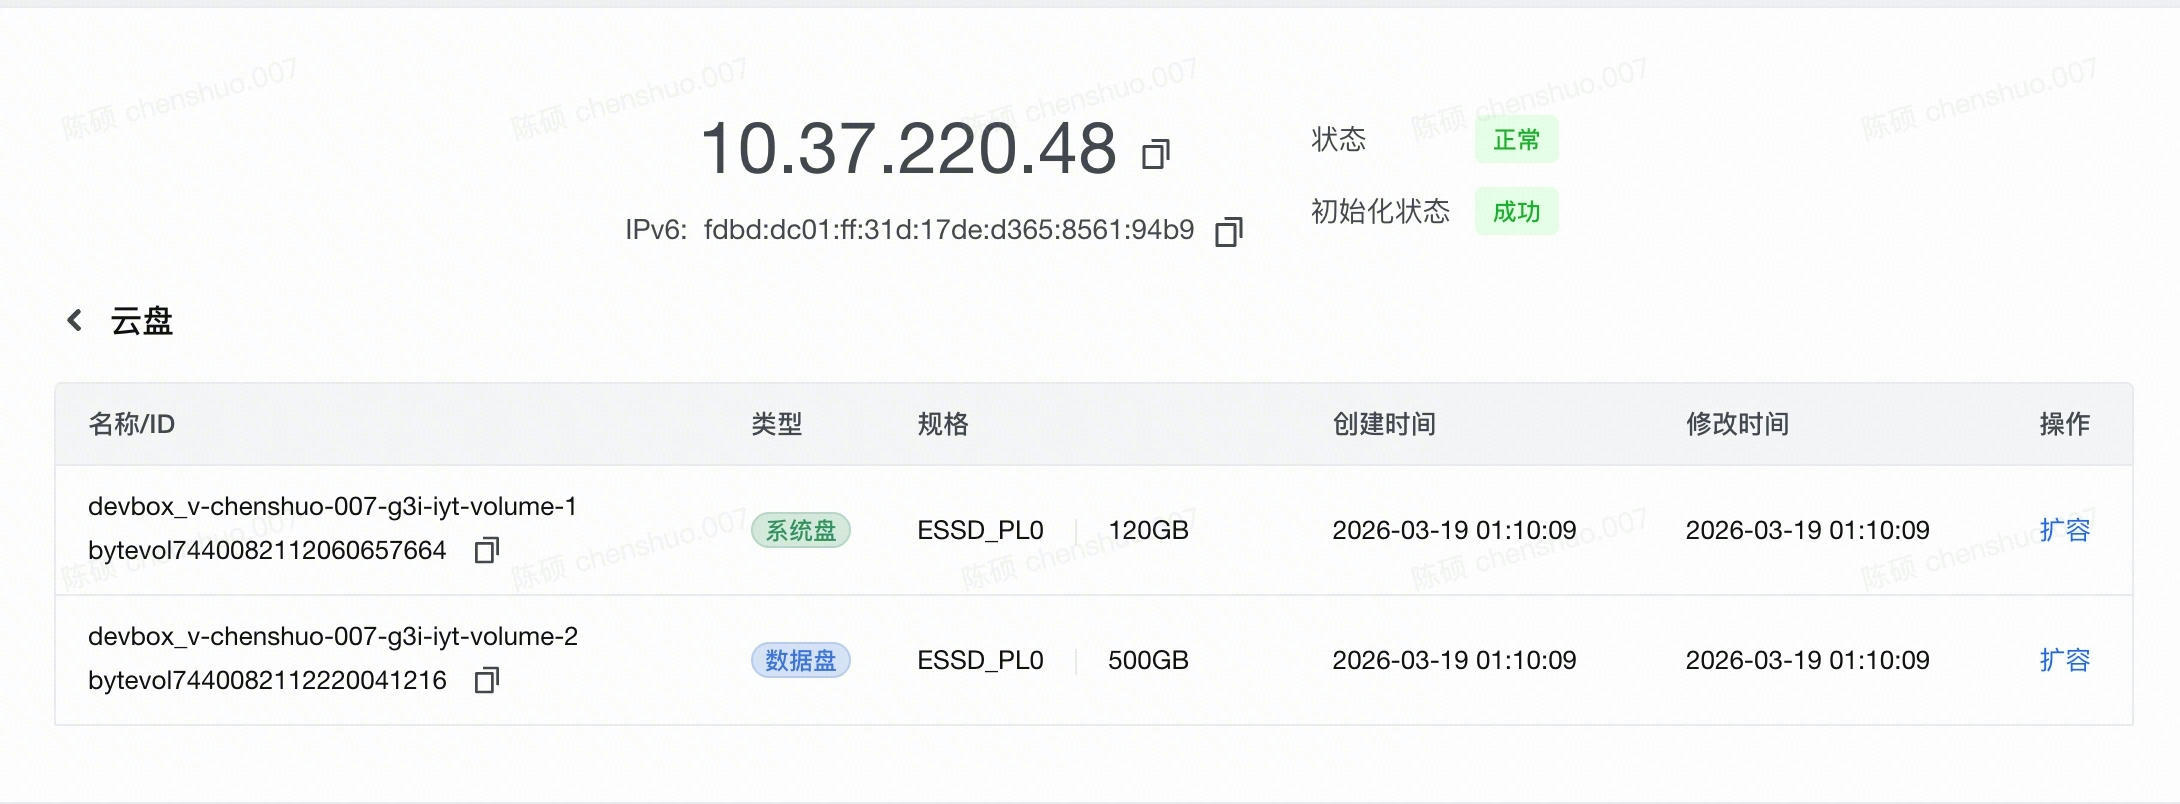
后续操作 首先先申请了一个数据盘500G,然后挂载到开发机上:
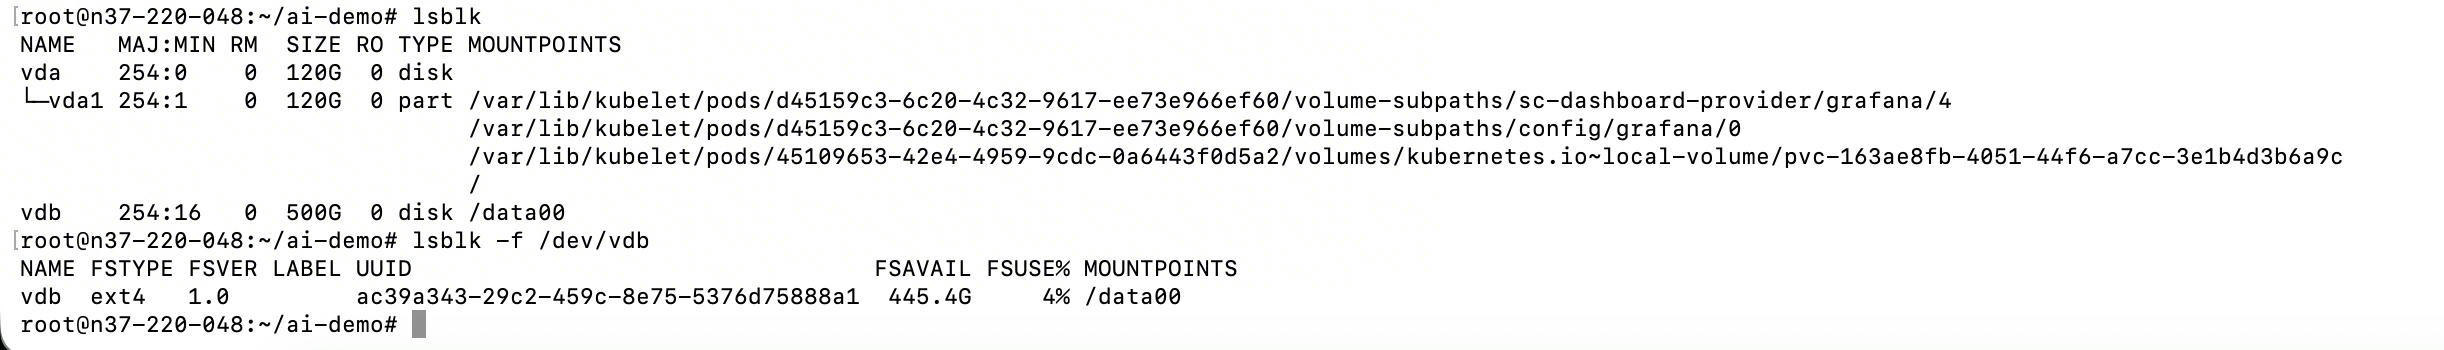
挂载的过程就不写了,最后用lsblk确认:
首先mkdir -p /data00/docker,创建一个文件来存储docker镜像,从原来默认的/var/lib/docker/overlay2文件夹里改放到这个500G的磁盘里。/var/lib/docker/overlay2是 Docker 的存储目录,使用的是 Overlay2 存储驱动。这里存放的是 Docker 容器和镜像的所有数据。如果你把里面的文件直接删了,那么再构建docker镜像就要从头跑一遍,不过如果你不小心把文件夹删了,就重启一下docker就会自动把对应的文件夹恢复。
这里需要sudo nano /etc/docker/daemon.json:
1
2
3
4
5
6
7
8
9
10
11
{ "registry-mirrors" : [ "https://docker.mirrors.ustc.edu.cn" , "https://hub-mirror.c.163.com" , "https://mirror.ccs.tencentyun.com" , "https://docker.nju.edu.cn" , "https://docker.xuanyuan.me" ], "data-root" : "/data00/docker" , # 这里是新加的 "storage-driver" : "overlay2" }
注意,nano打开的文件要用Ctrl + O保存,然后Ctrl + X退出。
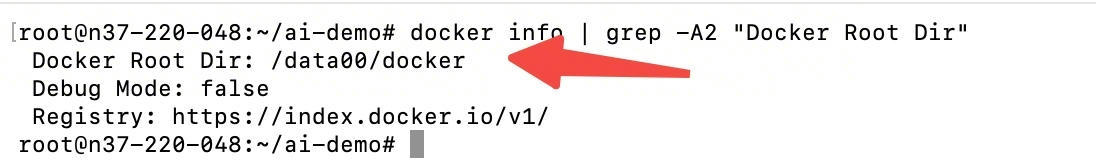
然后启动docker之后,用docker info | grep -A2 "Docker Root Dir"来确认一下:
搞完了docker镜像的新路径,现在搞一下k3s的。毕竟k3s ctr images import默认就是写到/var/lib/rancher/k3s/agent/containerd里的,如果还在这个120G的系统盘上,早晚还要爆。
这里可以骚一下,用软链接方法:
1
2
3
4
1. 迁移旧目录:sudo mv /var/lib/rancher/k3s /data00/ 2. 做软链接:sudo ln -s /data00/k3s /var/lib/rancher/k3s 3. 重启 K3s:sudo systemctl restart k3s 这样对于 K3s 来说,它以为自己还在读 /var/...,但物理上每一字节都写在了新的 500G 大盘上。
如果中规中矩的话,就是这样:
1
2
3
4
5
6
7
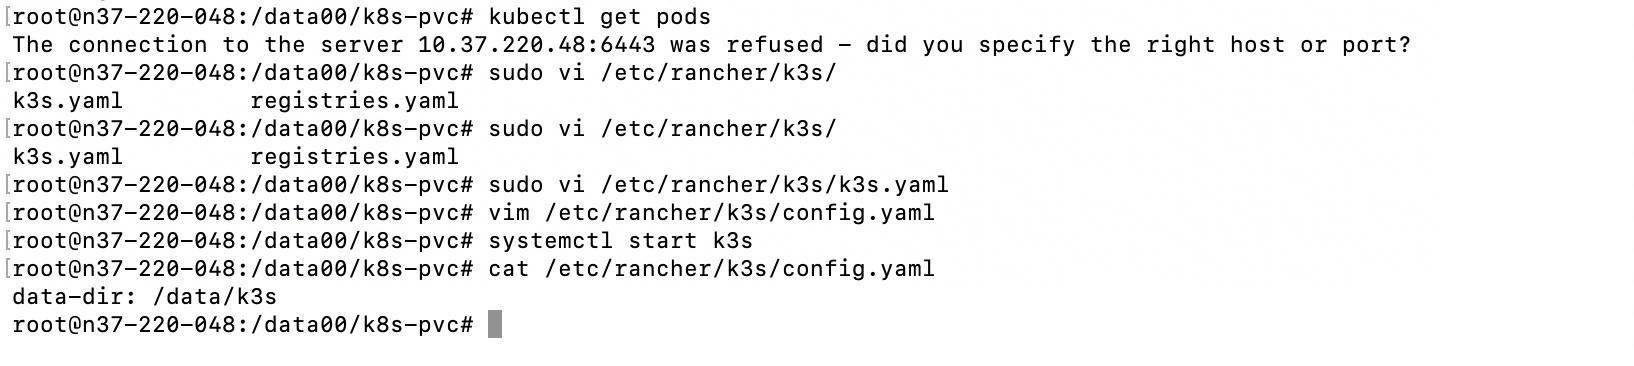
mkdir -r /data00/k3ssudo rsync -avPr /var/lib/rancher/k3s/ /data00/k3s/ vim /etc/rancher/k3s/config.yaml data-dir: /data00/k3s systemctl start k3s
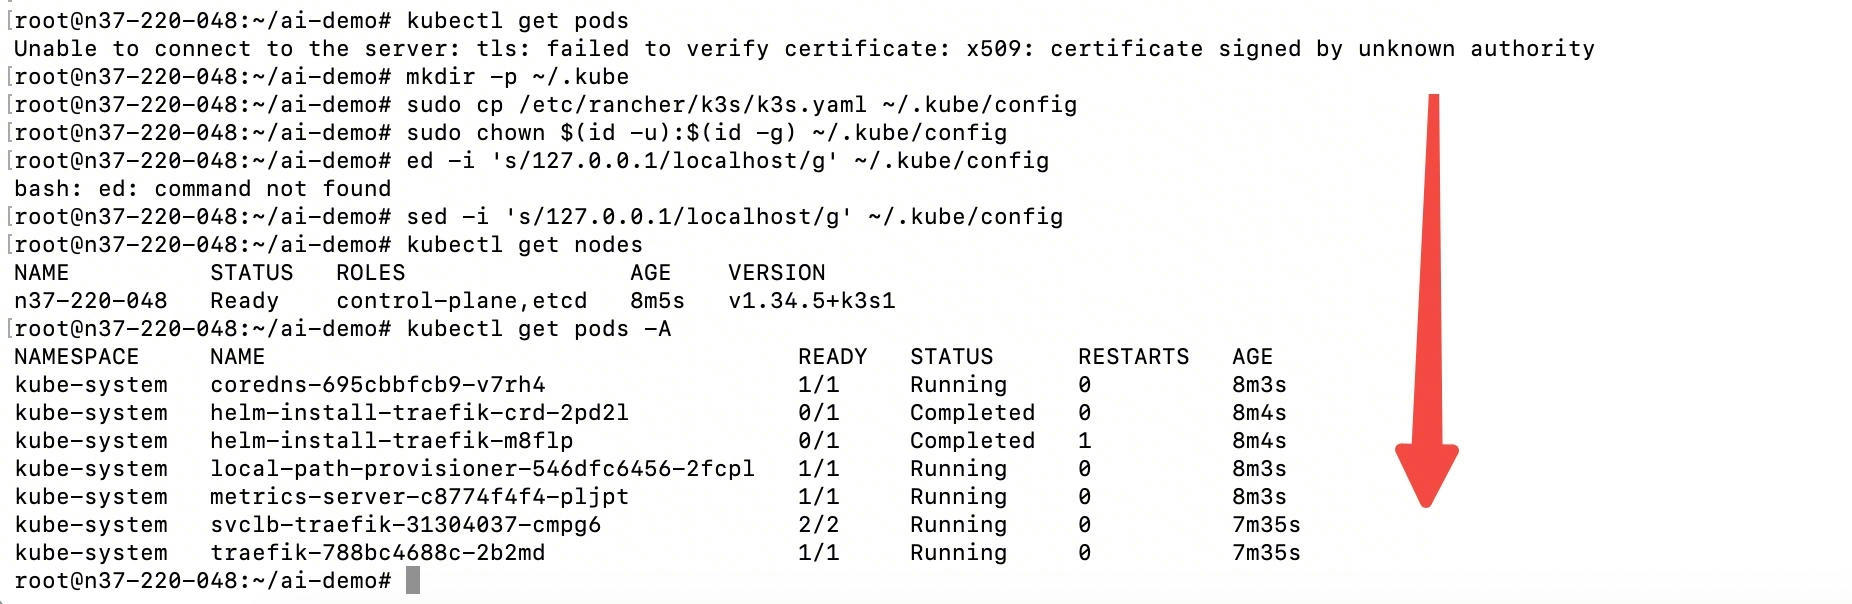
如果发现k3s启动不起来了,就按照下面的方法试一下:
1 2 3 4 5 6 7 8 9 10 11 mkdir -p ~/.kubesudo cp /etc/rancher/k3s/k3s.yaml ~/.kube/configsudo chown $(id -u):$(id -g) ~/.kube/configsed -i 's/127.0.0.1/localhost/g' ~/.kube/config kubectl get nodes kubectl get pods -A
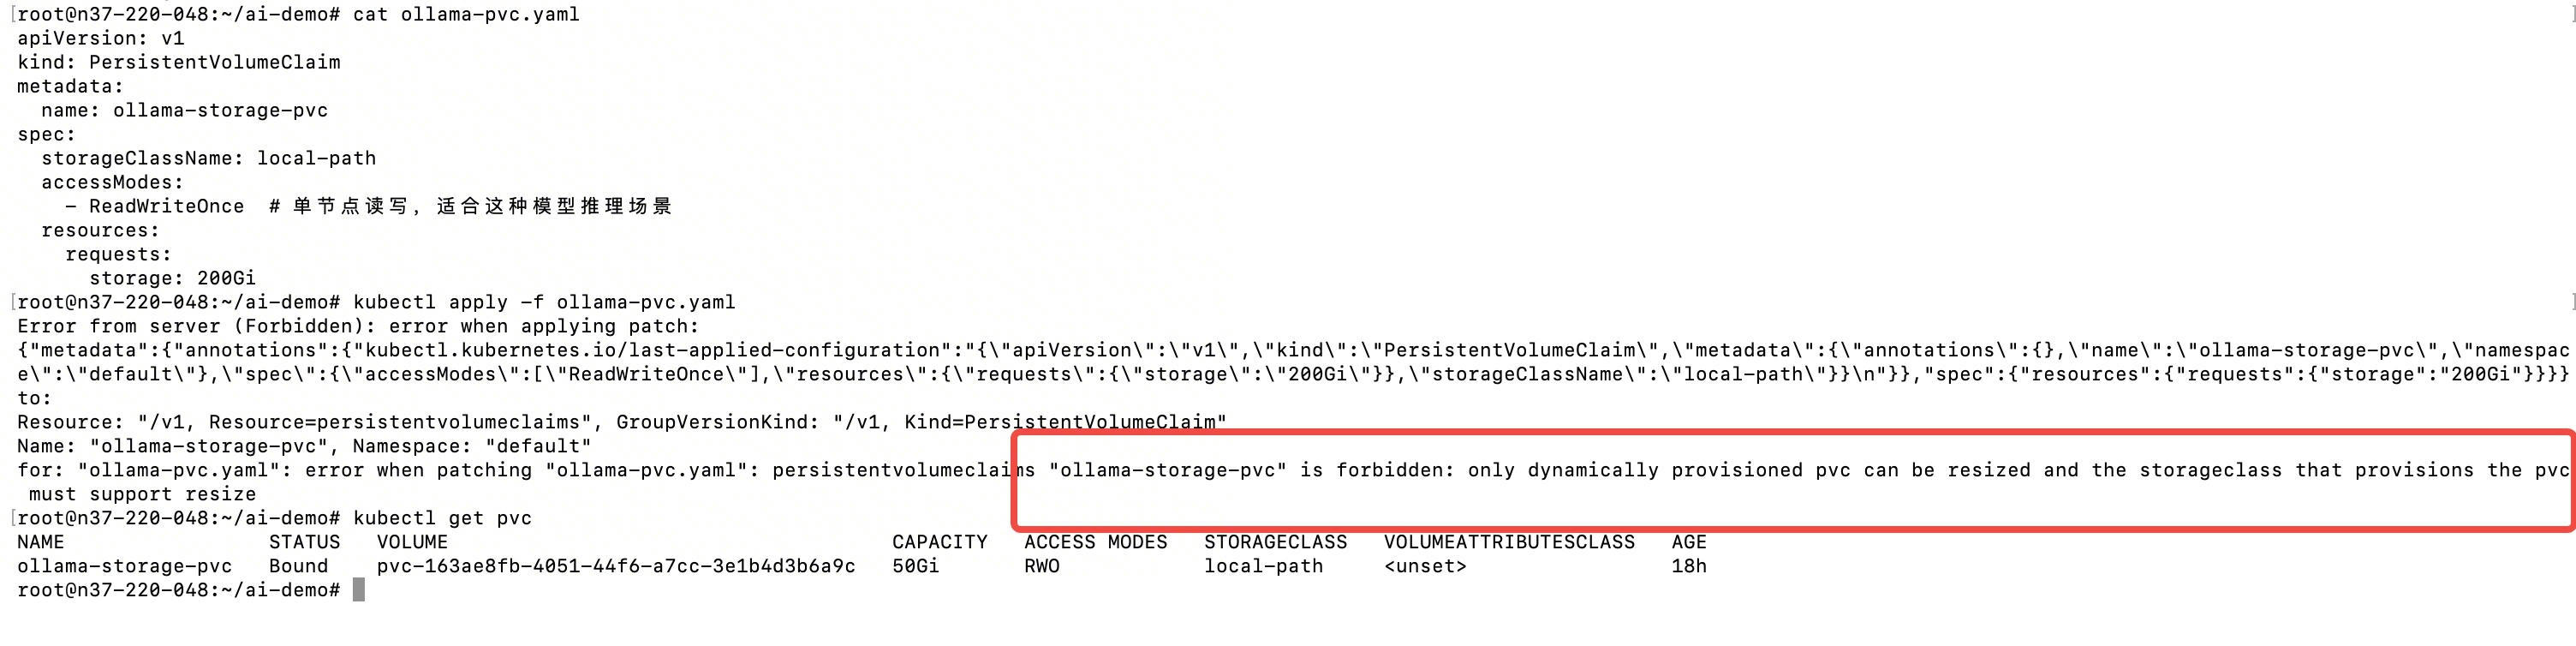
虽然我们加上了500G的数据盘,但是之前ollama-pvc.yaml没法改,只能直接apply -f启动:
1
2
3
4
5
6
7
8
9
10
11
12
# ollama-pvc.yaml apiVersion: v1kind: PersistentVolumeClaimmetadata: name: ollama-storage-pvcspec: storageClassName: local-path # 他现在会自动指向/data00/k3s了 accessModes: - ReadWriteOnce # 单节点读写,适合这种模型推理场景 resources: requests: storage: 50 Gi #这里不能改了,只有动态供应的 PVC 才能扩容,`local-path` StorageClass 不支持扩容
如果你要是启动就会报错:
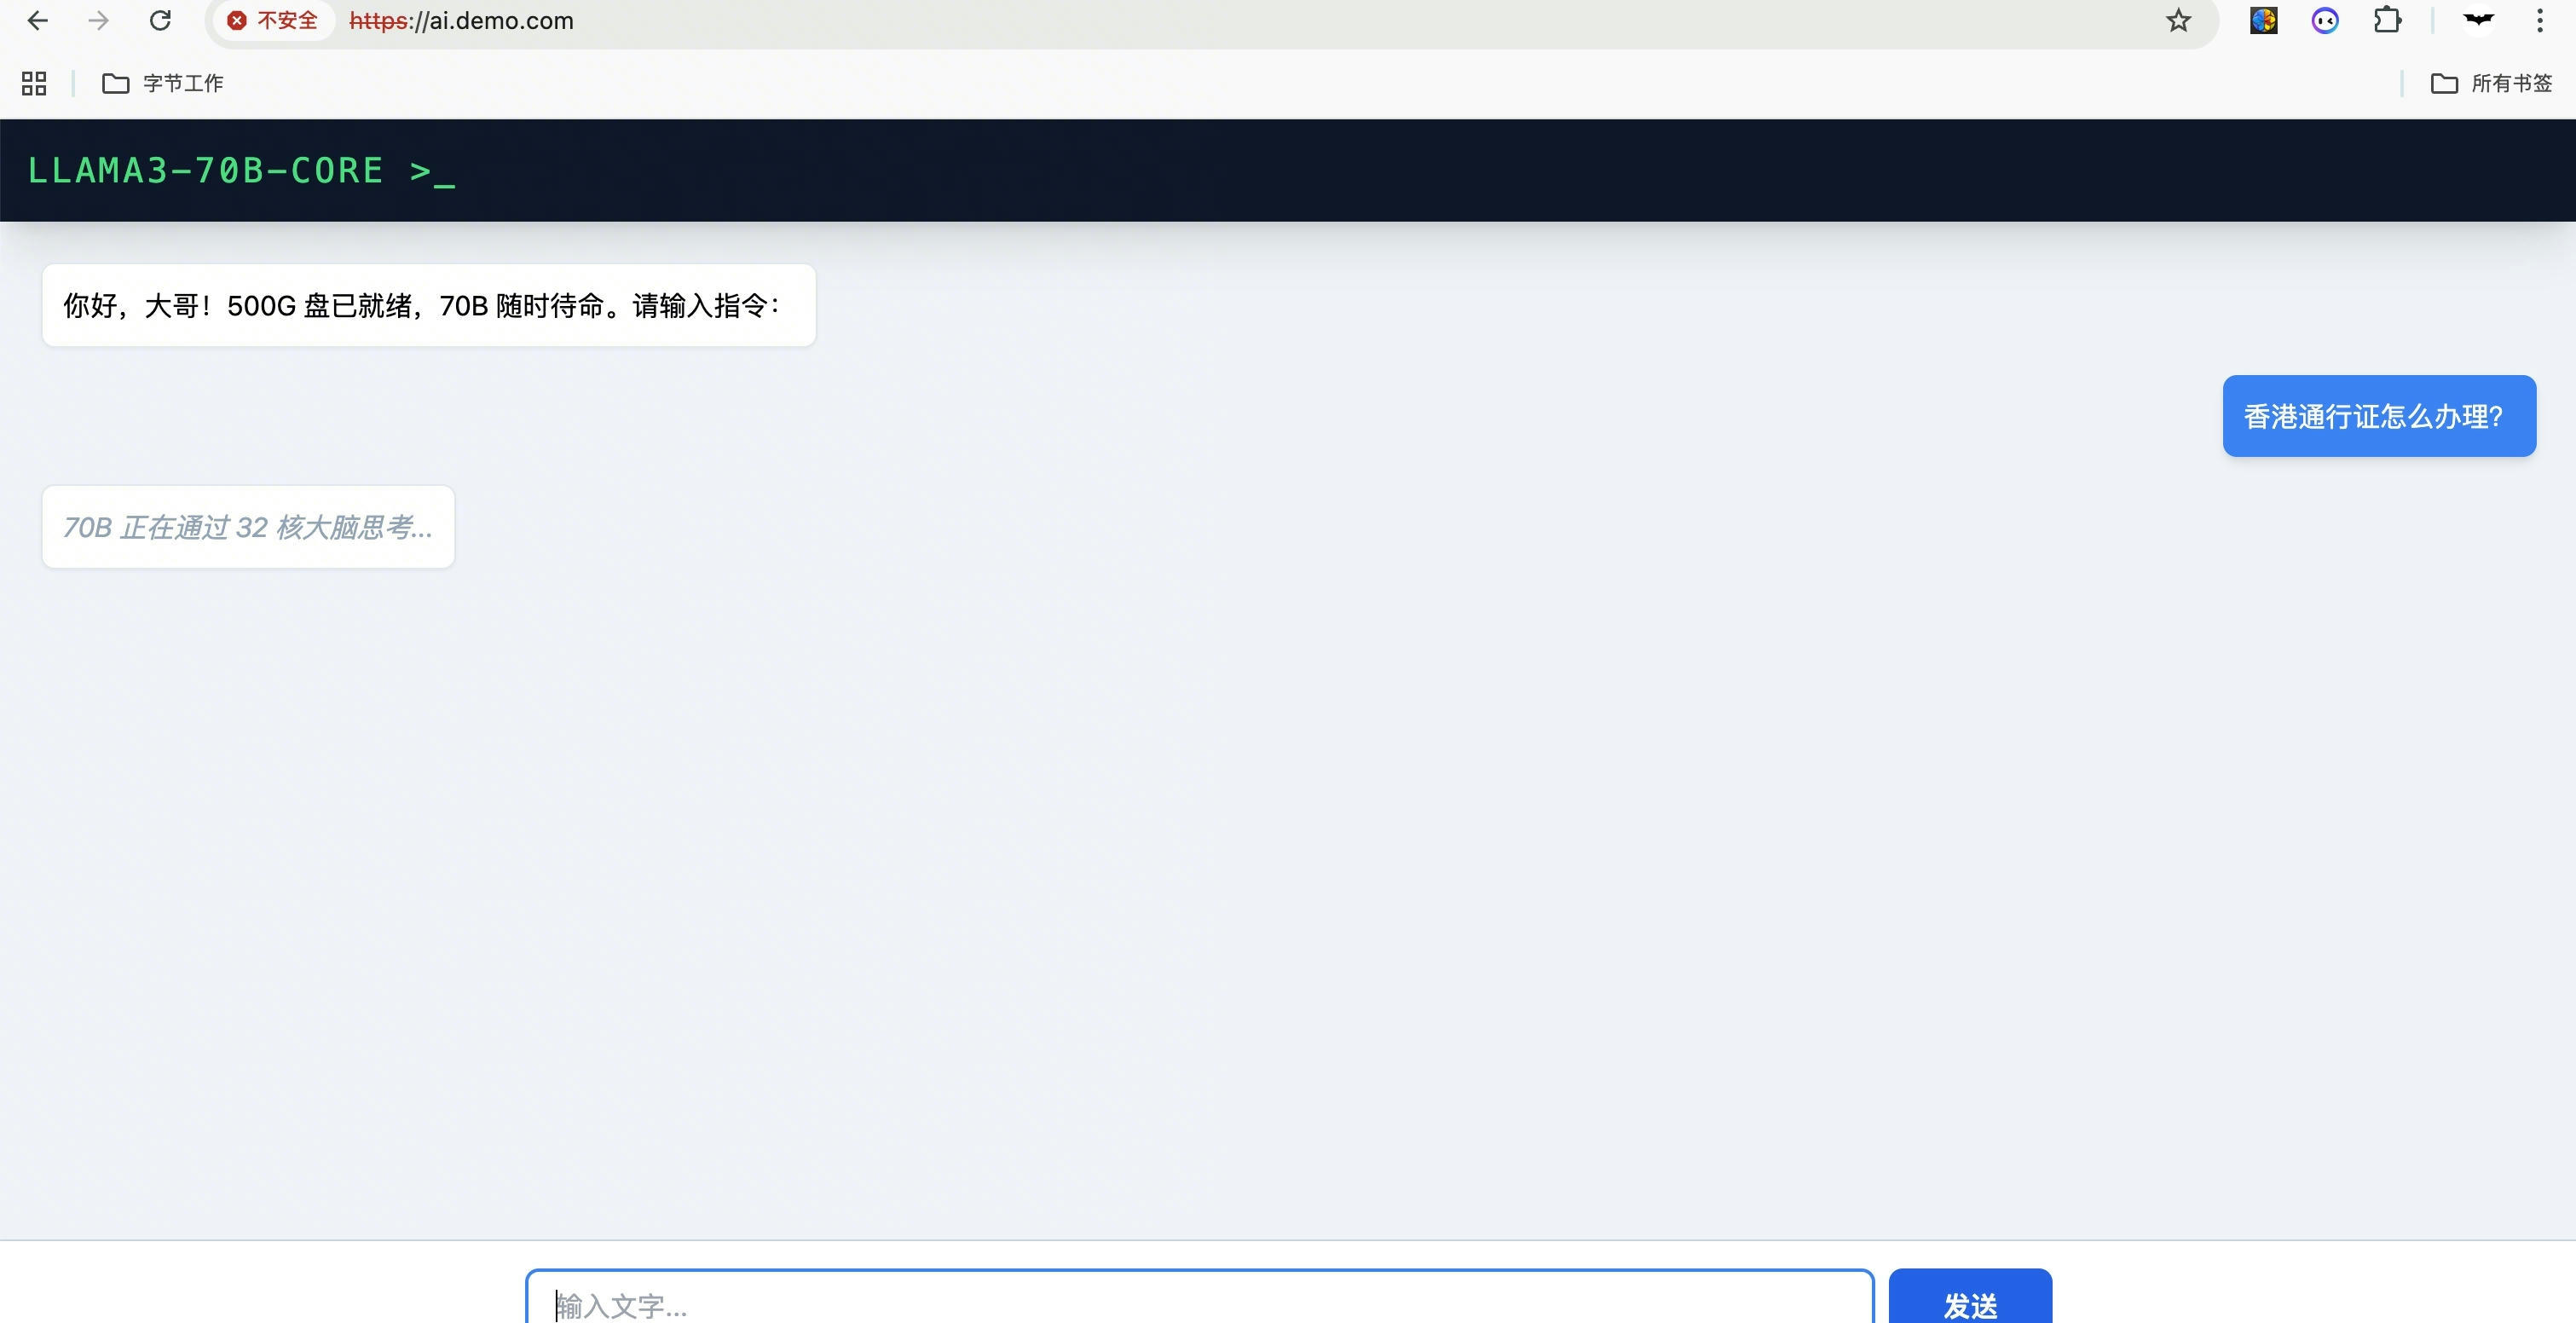
然后随着pod全部恢复之后,页面恢复正常:
如果要删除k3s的镜像的命令就是:
1
2
k3s ctr images list k3s ctr images rm 对应的REF